TTSapi
Transformar um modelo de voz em uma API utilizável.
O verificador analisou o AST Python e o JSON do dashboard sem carregar pesos ou executar inferência. Não há medições publicadas de latência ou qualidade de voz.
Origem e contribuição
O TTSapi adapta StyleTTS2 para uma superfície HTTP de síntese de voz. O modelo, módulos de treinamento e pesquisa original pertencem aos autores do StyleTTS2; minha contribuição aqui é a adaptação de serviço e integração de API.
O problema de engenharia é transformar inferência em uma operação com parâmetros, autorização, controle de concorrência, formato de resposta e diagnóstico. A página não atribui a mim a criação do modelo nem os resultados publicados pelos pesquisadores.
Carregamento e dispositivos
TTSService seleciona CUDA quando disponível e CPU como alternativa. O cache organiza modelos por nome e dispositivo, evitando recarregamento desnecessário no mesmo processo. Configuração, checkpoints e módulos auxiliares compõem a preparação para inferência.
O uso de torch.inference_mode reduz o trabalho associado a treinamento; mixed precision é condicional à GPU e configuração. O repositório implementa esses caminhos, sem um benchmark próprio que comprove aceleração em todos os dispositivos.
Contrato de síntese e áudio
A rota de síntese recebe texto, modelo, parâmetros de difusão, formato e uma voz salva ou áudio de referência. A referência passa por leitura e conversão para mono antes de compor a representação de estilo.
A resposta fornece bytes de áudio com media type correspondente. WAV, MP3, FLAC e OGG representam formatos de entrega; suporte ao formato não significa que qualidade perceptual ou tempo de resposta tenham sido medidos.
Concorrência, jobs e memória
Um semáforo serializa a região de inferência compartilhada. O endpoint de jobs inicia trabalho em thread e registra estados queued, running, completed ou failed em um dicionário local. Essa separação permite estudar uma resposta de submissão diferente da produção do áudio.
O estado e os resultados não formam uma fila durável. Reiniciar o processo perde os jobs; criar threads por requisição também precisa de limites. A rota direta executa trabalho síncrono dentro do handler assíncrono, ponto importante para evolução da capacidade.
Vozes, autenticação e limites
O serviço lista, cria e remove presets de voz, armazenando representações de estilo para reutilização. JWT bearer controla acesso às rotas protegidas; um limitador por identidade acompanha chamadas dentro de uma janela temporal.
Credenciais e políticas de produção precisam substituir os defaults de desenvolvimento. O rate limit em memória não coordena múltiplas réplicas e nomes de presets e uploads exigem validação adicional antes de exposição pública.
Observabilidade, verificação e evolução
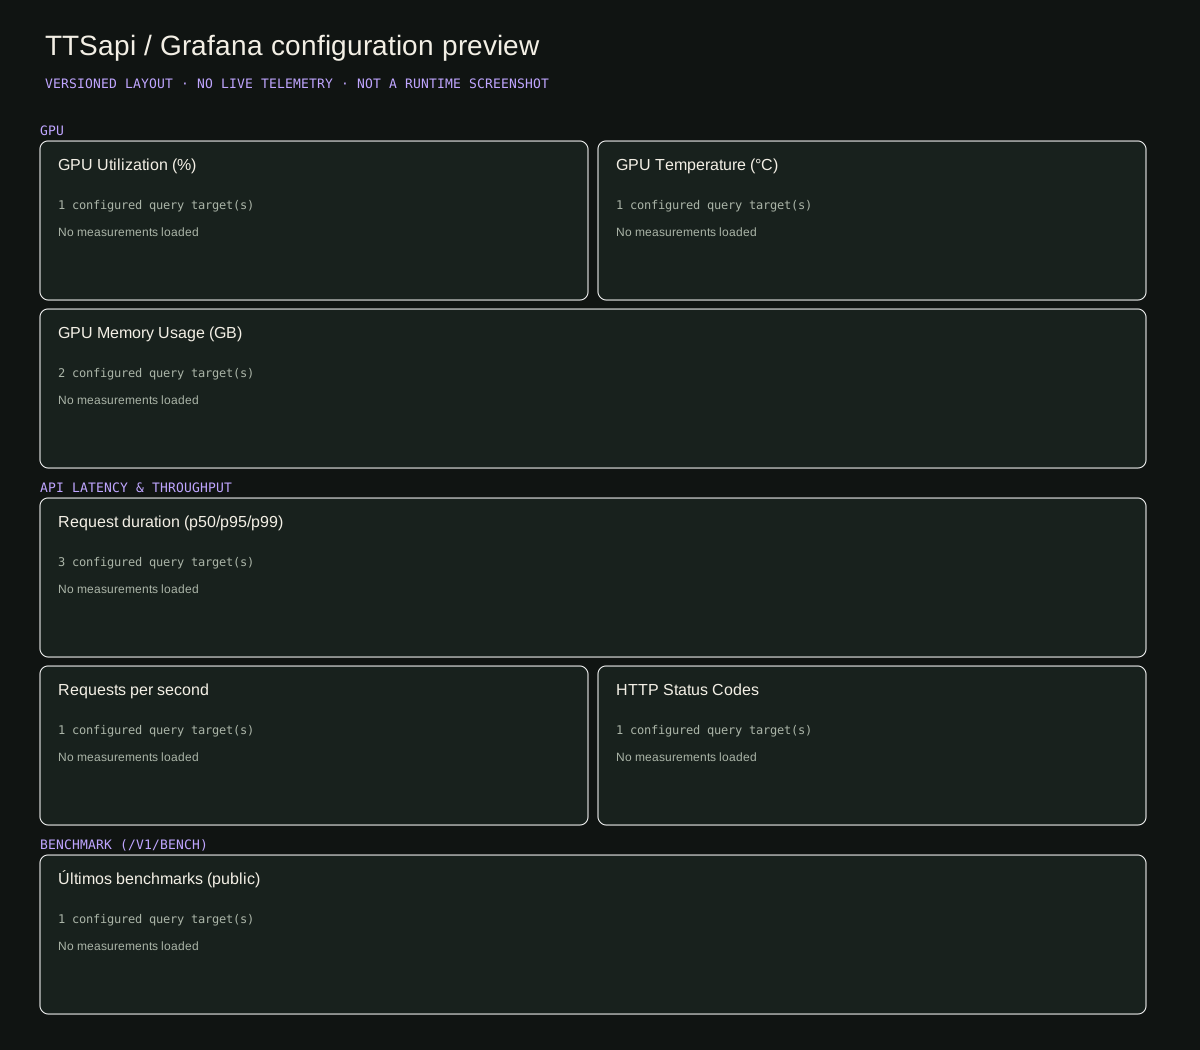
Prometheus instrumenta a API e métricas de GPU, quando NVML está disponível, acompanham memória, utilização e temperatura. Rotas de saúde e benchmark compõem ferramentas de diagnóstico; Docker e configurações de monitoramento organizam o ambiente.
A revisão inspecionou o serviço sem baixar ou executar pesos, sintetizar áudio ou medir GPU. Os próximos passos incluem fila limitada e persistente, isolamento do trabalho bloqueante, validação de entradas e testes automatizados do contrato HTTP.