MERCURY
Integrar mercados exige mais do que comparar preços.
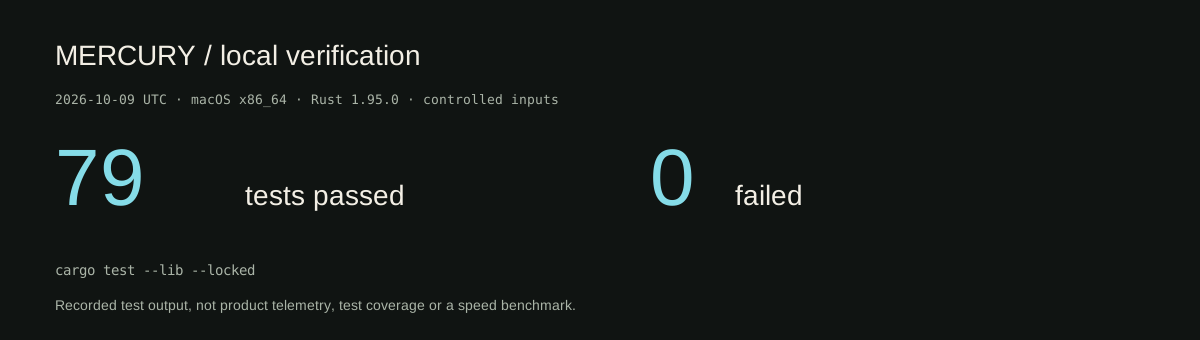
Suíte offline com fixtures, mocks e SQLite. Um snapshot de alerta desatualizado foi corrigido antes da execução final. Zero falhas; não houve negociação real.
Objetivo e diferença em relação ao Argus
O MERCURY é uma pesquisa de engenharia para integrar mercados de previsão e examinar oportunidades entre plataformas. Diferentemente do Argus, que enfatiza a fundação de dados e replay, seu foco inclui comparação de preços, custos, execução em múltiplas pontas e acompanhamento de posições.
A oportunidade teórica precisa sobreviver à liquidez disponível, taxas, atraso dos feeds e falhas de execução. O projeto modela esses problemas no código, sem apresentar rentabilidade validada ou operação real como resultado deste estudo.
Arquitetura assíncrona e fluxo de eventos
Rust e Tokio sustentam tasks de feeds, detecção, execução, inventário e monitoramento. Canais transportam oportunidades validadas, resultados de negociação e alertas; traits separam acesso ao banco e clientes de ordens de suas implementações.
O fluxo é orientado a eventos: um tick modifica o livro de um mercado, desencadeia a avaliação correspondente e pode produzir uma oportunidade. Essa organização reduz a necessidade de varrer todos os mercados a cada atualização.
Feeds, descoberta e normalização
O repositório contém adaptadores para Polymarket, Kalshi, CDNA e ForecastEx, além de descoberta e registro de mercados. Cada integração tem contratos próprios de identificação, autenticação e representação de preços.
A camada de normalização converte entradas em ticks comparáveis com sequência, timestamp, preço, quantidade, profundidade e taxa. Associar mercados requer atenção à pergunta, resolução e expiração; preços semelhantes não bastam para provar equivalência econômica.
Livro unificado e spread líquido
O UnifiedOrderBook organiza dados por mercado e plataforma. O NetSpreadEngine avalia direções de compra complementares e calcula a diferença após custos, usando rust_decimal para representar preços e valores.
Taxas, estimativas de slippage e custos on-chain entram no cálculo. A profundidade disponível limita o tamanho avaliado; caminhar pelo livro permite estimar o preço de execução além do melhor nível. Essas estimativas continuam dependentes da qualidade e atualidade dos dados.
Detecção, rejeições e dimensionamento
O detector registra razões de rejeição relacionadas a spread, liquidez, dados antigos, exposição e orçamento de risco. Também acompanha atividade de plataformas, concorrência e históricos utilizados para ajustar limiares em condições de volatilidade.
BankrollManager e KellyCalculator fazem parte da camada de dimensionamento. São mecanismos de pesquisa implementados, não uma recomendação de alocação. A presença de uma fórmula no sistema não demonstra que seus pressupostos estejam calibrados para um mercado real.
Circuit breakers e interrupção controlada
A camada de breakers considera tamanho da operação, perdas, drawdown, exposição por plataforma e mercado, exposição agregada, falhas consecutivas e atraso dos feeds. Limiares e estado de pausa dão uma representação explícita aos motivos para interromper novas operações.
Um cooldown pode controlar retomadas após determinadas condições. O valor de engenharia está em transformar condições de risco em estado e decisões testáveis; a adequação dos limites exige avaliação independente do código.
Execução, idempotência e falhas parciais
ExecutionEngine recebe oportunidades validadas e usa clientes específicos por plataforma. O código oferece modo dry-run, cache LRU de oportunidades já processadas e tratamento de rate limits com backoff.
Executar duas pontas não é uma transação atômica entre plataformas. O resultado modela preenchimento, preço, quantidade, taxa e erro; caminhos de unwind e acompanhamento de posições tratam o caso em que apenas uma ponta é preenchida.
Inventário, reconciliação e persistência
PositionTracker recebe resultados e mantém o inventário persistido. Reconciler compara estado com informações disponíveis das plataformas; SettlementMonitor acompanha resolução. Um watchdog procura posições órfãs e sinaliza ou tenta reduzir exposição conforme o caminho implementado.
A camada Database tem implementação SQLite com SQLx e migrações. Essa separação facilita testes com banco em memória e permite examinar o comportamento após uma falha, em vez de depender apenas de logs transitórios.
Telemetria e testes de cenários
Contadores atômicos acompanham ticks, spreads, oportunidades, reconexões e falhas por plataforma. Health checks, alertas e relatórios via Telegram compõem superfícies de operação, mantendo monitoramento separado do processamento principal.
Testes de integração usam SQLite em memória e clientes simulados para cenários de oportunidade, spread insuficiente, dados antigos e regras de risco. Há testes de feeds, propriedades e snapshots. A execução local da suíte de biblioteca passou em 79 testes após a correção de um snapshot de alerta desatualizado. Não foram executadas ordens nem medidos ganhos ou latência.
Estado atual e competências
O projeto demonstra APIs externas, programação assíncrona, precisão decimal, modelagem de eventos, persistência, testes e recuperação de falhas parciais. Ele conecta problemas econômicos à engenharia de sistemas distribuídos.
A validação restante inclui conectores em ambiente controlado, equivalência dos mercados, reconciliação e comportamento sob falhas reais. Esta página apresenta um repositório público; não apresenta garantias de lucro, disponibilidade ou segurança operacional.